 다음수능
근거와 방법
AI 수능 성적과 문항 구성은 공개 자료를 다시 집계한 값입니다. 제안에는 그 값을 보고 실제로 검증해야 할 질문을 담았습니다.
AI 벤치마크
개인이 운영하는 공개 벤치마크에서 한 문항씩 풀게 한 설정 151개 중 틀린 문항을 다시 풀게 한 6개는 뺐습니다. 남은 145개 가운데 93개는 운영자가 표시한 학습 기준일이 시험보다 앞섰고, 41개는 시험 이후, 11개는 기준일을 알 수 없었습니다. 모델별 학습 완료일을 개발사 공시와 대조하지 않았습니다.
시험보다 앞선 것으로 분류한 설정의 최고점은 선택과목 평균 방식 445.0점, 수험생처럼 과목을 고른 최고 조합에서 450점입니다. 13개 섹션을 모두 맞힌 설정은 시험 공개 이후까지 학습한 것으로 표시됐습니다. 여러 문항을 섹션 단위로 풀게 한 별도 설정의 최고점은 448.5점이었습니다.
문제는 사람이 옮긴 텍스트와 일부 그림으로 입력했습니다. 평가원 응시자 수와 만점자 수는 실제 시험의 공식 집계입니다. 벤치마크와는 점수 집계 방식도 응시 조건도 다릅니다.
벤치마크 저장소 평가원 브리핑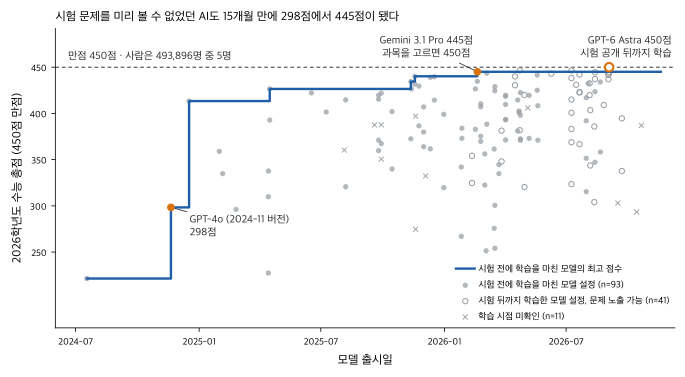
두 시험의 문항 분류
2026학년도 수능 국어·수학·영어·한국사를 응시자 1인 기준 140문항으로 환산하고, 1869년 하버드 입학시험 전사본의 55문항을 비교했습니다. 응답 형식과 인지 요구는 별도로 분류했습니다. 두 시험은 순서도 배점도 응시 목적도 다릅니다. 이 비교에서는 문항 형식의 차이를 확인할 수 있습니다.
문항은 AI가 분류했고 사람 코더는 참여하지 않았습니다. 인지 요구에 관한 AI 분류 간 일치도는 수능 κ=0.51, 하버드 κ=0.89였습니다. 수능에서 이해·추론·적용의 비중은 분류 방식에 따라 71.0~76.3%였습니다. 탐구는 집계 범위에서 제외했습니다.
하버드 시험 전사본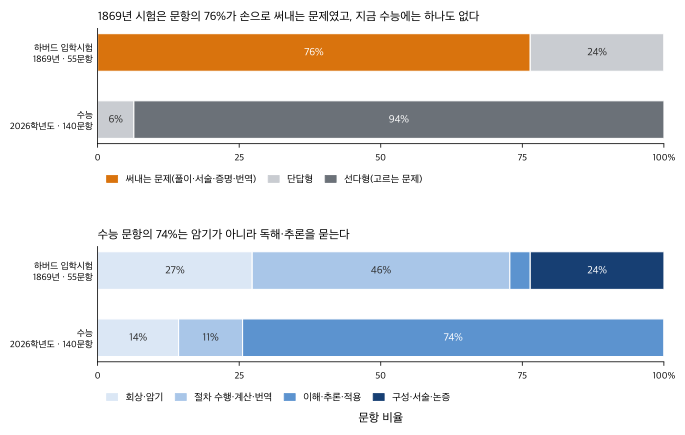
한국의 대입과 다른 평가 제도
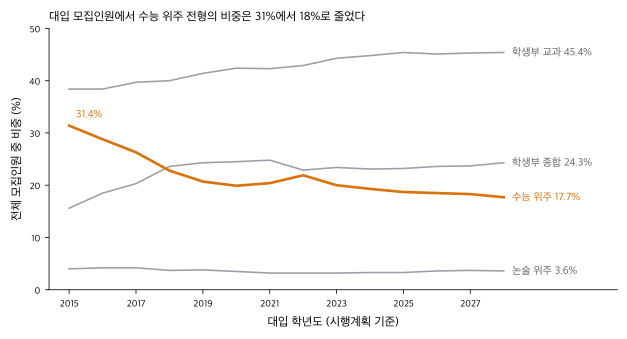
졸업생은 수능 지원자 기준입니다. 만 18세 인구는 장래인구추계입니다. 모집 비중은 시행계획 기준이고 수시의 수능 최저학력기준은 넣지 않았습니다. 추세 사이의 인과관계는 따로 연구해야 알 수 있습니다.
평가원 접수 결과 대교협 시행계획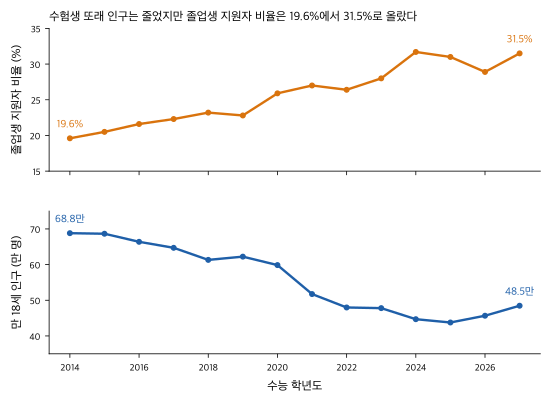
| 국가 | 시험 및 응시 기회 | 응답 형식 |
|---|---|---|
| 한국 | 대학수학능력시험(수능) 연 1회(11월; 2027학년도는 2026-11-19 시행) | 선다형 중심(국어·수학·영어·탐구 등). 서술·구술 없음. 문항 형식 세부 비율은 미확인(평가원 실시요강 확인 필요) |
| 독일 | 아비투어(Abitur) 연 1회(졸업 시) | 4~5개 시험과목: 최소 3과목 지필(논술형 중심), 최소 1과목 구술. 최종 점수의 약 2/3는 2년간 과목 성적, 1/3은 졸업시험(최대 900점, 300점 이상 합격) |
| 프랑스 | 바칼로레아(일반·기술 바칼로레아) 연 1회(6월 중심; 1학년(première) 말 사전시험 + 졸업학년 시험) | 논술형 지필(철학·전공과목·프랑스어) + 구술 "그랑 오랄"(약 20분, 2차 자료). 내신(contrôle continu) 40%, 최종시험 60% |
| 일본 | 대학입학공통테스트 + 대학별 개별학력검사(2차 시험) 공통테스트 연 1회(1월; 2026년 1/17~18, 650개 시험장) | 공통테스트는 마크시트식 객관식 중심(형식 비율 미확인). 개별시험은 대학별 서술·논술·면접 등 |
| 핀란드 | 대입자격시험(Ylioppilastutkinto) 연 2회(봄·가을), 최대 3회 연속 시험기에 나누어 응시 가능 | 전 과목 디지털(Abitti, 2019년 봄 완전 전환). 최소 5개 시험. 서술형 중심(형식 비율 미확인) |
나라마다 시험이 자격 부여와 선발에서 하는 역할이 다릅니다. 운영 기관과 문헌별 출처는 데이터 팩의 제도 비교표에 있습니다.
평가 문헌의 근거 수준
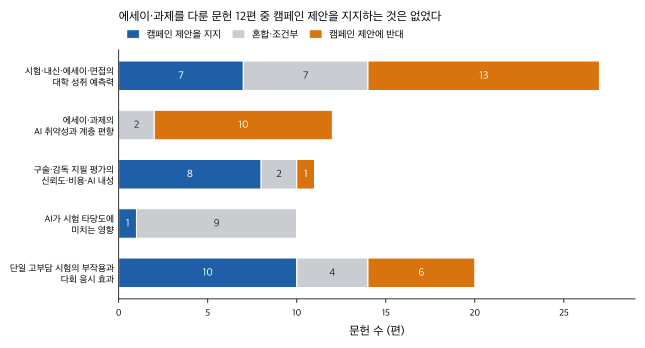
문헌 80편 가운데 원문은 7편, 초록은 67편을 확인했고 6편은 2차 인용입니다. 문헌마다 연구 설계와 범위가 달라서 방향 분류를 효과 크기로 읽을 수 없습니다. 국내 연구는 초록을 기준으로 정리했습니다. 수능과 내신 중 어느 쪽이 한국 대학 학업성취를 더 잘 예측하는지는 더 검증해야 합니다.
AI가 높은 점수를 받으면 그 시험의 사람 선발 타당성이 떨어진다고 직접 검증한 연구는 검토한 문헌에서 찾지 못했습니다. 집에서 쓰는 에세이와 과제는 누가 썼는지 확인하는 방법이 연구 과제로 남아 있습니다. 현장 서술형도 채점 신뢰도와 비용, 학생 배경에 따라 효과가 달라지는지를 검증해야 합니다.
국내에서는 여러 자료를 읽고 이를 근거로 주장하는 국어과 문항이 제안된 적이 있습니다. 문항 설계 연구여서 대규모 선발에서도 효과가 있는지는 따로 검증해야 합니다. 최숙기(2023) 초록
자료 업데이트
· 2026학년도 본시험과 2027학년도 9월 모의평가 벤치마크를 반영했습니다. 2027학년도 본시험의 부정행위 집계는 다음 차례에 검토합니다.
· 2027학년도 본시험 결과를 30개 모델·설정으로 갱신했습니다. 2027학년도 수능 인공지능 풀이 결과
국어·수학의 EBSi 가채점 예상 등급과 영어·한국사의 절대평가 등급을 추가했습니다. 등급 산정 기준
별도 풀이 세션에서 나온 한국사·탐구 만점 사례와 반복 실행에서 오답을 낸 모델을 추가했습니다. 한국사·탐구 풀이 결과
한국사 실측 점수를 우선 적용하고 미집계 모델은 공개 원점수로 보완했습니다. 탐구 17과목의 공개 원점수도 추가했습니다. 종합 원점수 · 한국사·탐구 풀이 결과
같은 홀수형 시험지로 별도 실행한 모델의 영역별 풀이 시간을 추가했습니다. 풀이 시간 측정 방법
· EntropyMath가 문항별 이미지로 평가한 2027학년도 국어·수학 첫 답안에서 오답 문항을 집계했습니다. 인공지능이 틀린 문제